
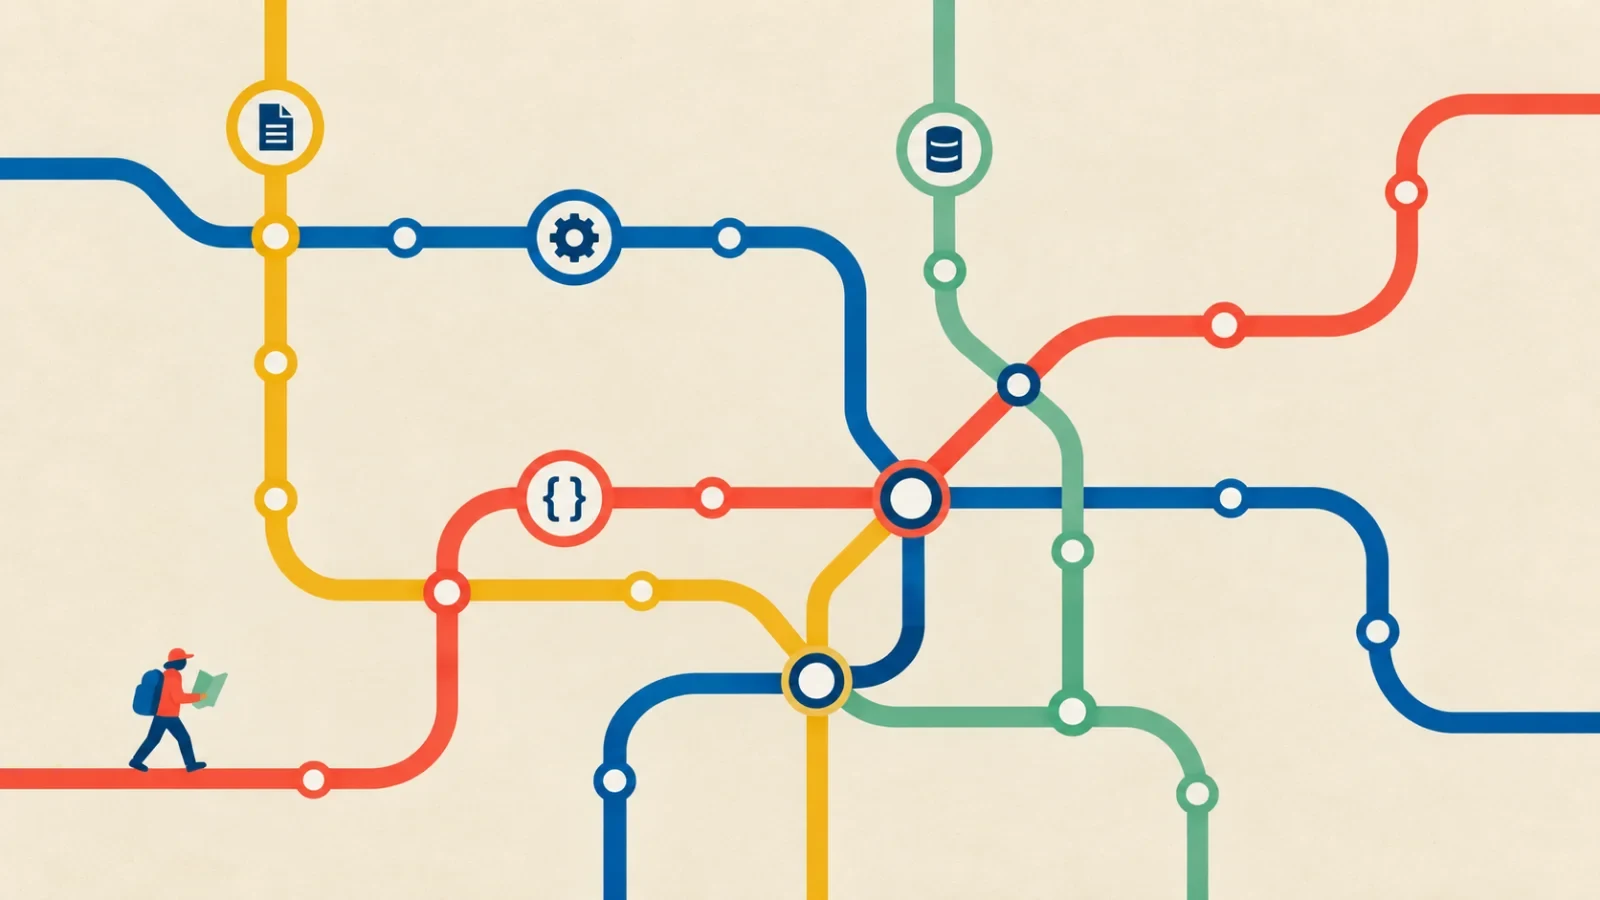
En el artículo anterior hablábamos de que la IA no "vive" todo el tiempo: se instancia cuando le hablas, atiende lo que le pides y se desocupa. Esa idea tiene una consecuencia muy práctica que casi nadie menciona: cada vez que abres una conversación nueva, tu IA llega a tu proyecto como si fuera su primer día de trabajo. No sabe qué archivos tienes, cómo se conectan entre sí, ni por qué escribiste algo de cierta manera.
Y ahí es donde se empiezan a quemar tokens. Un token es, a grandes rasgos, un pedacito de texto (una palabra o parte de ella) que la IA lee o escribe, y tanto los límites de uso como el costo de estas herramientas se miden en ellos. Mientras más texto tiene que leer la IA para entender tu proyecto, más tokens gasta, y más recursos consume cada pregunta que le haces. Si la semana pasada hablábamos de cuánto le cuesta al planeta cada prompt, hoy hablamos de una forma de no desperdiciarlos.
Un turista sin mapa
Imagina que llegas a una ciudad que no conoces y le pides a alguien: "ayúdame a encontrar esta dirección". Si esa persona no tiene mapa, no le queda otra que recorrer calle por calle hasta dar con ella. Va a llegar, pero va a gastar muchísimo tiempo y energía. Con un mapa, en cambio, traza la ruta en segundos.
Eso es exactamente lo que le pasa a la IA con tu código. Si le dices "tengo un bug en alguna parte del proyecto, ahí verás cómo lo encuentras", abre archivo tras archivo buscando por dónde empezar, y cada archivo que lee cuenta como tokens. En un proyecto pequeño casi no se nota. En uno de cientos o miles de archivos, sí.
¿Qué es Graphify?
Graphify es una herramienta open source que convierte tu proyecto (código, documentación, PDFs, imágenes e incluso video) en un grafo de conocimiento que tu asistente de IA puede consultar en vez de leer archivos uno por uno. Se instala como una skill dentro de herramientas como Claude Code, Cursor, Codex, Gemini CLI o GitHub Copilot, entre más de veinte plataformas compatibles, y ya supera las 120 mil estrellas en GitHub.
¿Y qué es un grafo? Piensa en el mapa de un metro: estaciones y líneas que las conectan. En Graphify, las "estaciones" son clases, funciones, archivos y conceptos, y las "líneas" son las relaciones entre ellos: este archivo importa aquel, esta función llama a esta otra, esta clase hereda de aquella. Tu proyecto, pero dibujado como un mapa.
Cómo funciona, sin tanta jerga
Según su documentación, Graphify procesa tu proyecto en tres pasadas:
- Código (gratis y local): analiza tu código con tree-sitter, que lo descompone en su estructura: qué clases, funciones e imports existen y cómo se llaman entre sí. Es determinista, no usa ningún modelo de IA y nada sale de tu máquina.
- Audio y video (local): los transcribe en tu propio equipo con faster-whisper.
- Documentos, PDFs e imágenes (usa IA): esta pasada sí usa el modelo de tu asistente para extraer conceptos y relaciones, y por eso sí consume tokens. Por eso existe el archivo
.graphifyignore(funciona igual que.gitignore): para dejar fuera lo que no aporta, comonode_modulesodist. Hay dos detalles de diseño que vale la pena resaltar. El primero: cada relación del grafo viene etiquetada comoEXTRACTED(encontrada directamente en el código),INFERRED(deducida) oAMBIGUOUS(incierta), así que siempre sabes qué se leyó y qué se adivinó. El segundo: no usa embeddings ni bases de datos vectoriales; es un grafo real que se recorre, y los subsistemas del proyecto se agrupan con un algoritmo de detección de comunidades (Leiden).
Qué te entrega
Al correr /graphify . en tu proyecto, obtienes una carpeta graphify-out/ con tres archivos:
graph.html: una visualización interactiva del grafo que abres en cualquier navegador.GRAPH_REPORT.md: un reporte con los "god nodes" (los conceptos más conectados, por donde pasa todo), conexiones sorprendentes entre módulos y preguntas sugeridas.graph.json: el grafo completo, que se puede consultar en cualquier momento sin volver a leer tus archivos. Y sí, ahí vuelve a aparecer un.mdhaciendo trabajo importante. Además, comandos comographify claude install(o el equivalente para tu herramienta) escriben instrucciones en tuCLAUDE.mdoAGENTS.mdpara que la IA consulte el grafo antes de ponerse a leer archivos. Es el mismo principio del artículo sobre los.md: contexto escrito para que la IA no tenga que adivinar.
Con el grafo construido, puedes preguntarle cosas a tu proyecto directamente:
graphify query "¿qué conecta la autenticación con la base de datos?"devuelve un subgrafo con lo relevante.graphify path "UserService" "DatabasePool"traza cómo se conectan dos cosas.graphify explain "RateLimiter"explica un concepto y todo lo que lo rodea.
Por qué vale la pena usarlo
- Menos tokens en proyectos grandes: en lugar de leer archivos completos, la IA consulta solo el pedazo del grafo que necesita. Según los benchmarks del propio proyecto, en un corpus mixto de 52 archivos el ahorro fue de 71.5 veces menos tokens por consulta.
- Entender un proyecto que no conoces: el reporte te muestra de un vistazo qué es lo más importante y qué módulos se conectan de formas inesperadas. Útil para repos heredados o para cuando entras a un equipo nuevo.
- Respuestas con rastro:
pathyexplainno solo responden, también muestran por dónde pasó la conexión, con su etiqueta de confianza. - El "por qué", no solo el "qué": los comentarios como
# NOTE:y# WHY:, y las referencias a ADRs o RFCs, se convierten en nodos enlazados al código que explican. - No empieza de cero cada vez: el grafo persiste entre sesiones, y una caché por hash solo reprocesa los archivos que cambiaron. Con
graphify hook install, además, se reconstruye solo en cada commit (solo la parte de código, sin costo de API). - Tu código se queda en tu máquina: el análisis de código es local. Solo los documentos, PDFs e imágenes pasan por el modelo de tu asistente.
La parte honesta: no es magia
Antes de que salgas corriendo a instalarlo, hay que decir algo importante. La propia documentación de Graphify reconoce que el ahorro depende del tamaño del proyecto:
| Corpus | Archivos | Reducción de tokens |
|---|---|---|
| Repos de Karpathy + papers + imágenes | 52 | 71.5x |
| Código de graphify + paper de Transformers | 4 | 5.4x |
| httpx (librería Python sintética) | 6 | ~1x |
Con seis archivos, todo ya cabe en la ventana de contexto de la IA, así que ahí el grafo aporta claridad, no ahorro.
Y hay más. A mediados de mayo de 2026 se fusionó un parche que respondía a un problema reportado por varios usuarios: Claude Code gastaba más tokens con Graphify instalado que sin él. La causa era que las instrucciones de instalación le decían a la IA que siempre leyera GRAPH_REPORT.md antes de cualquier búsqueda, y en proyectos reales ese reporte pesa entre 12 y 25 mil tokens. En una prueba sobre un monorepo de Go de unos 1,500 archivos, la versión anterior necesitó 5 llamadas y 34 mil tokens, contra 4 llamadas y 30 mil sin Graphify. Con el parche, que le indica a la IA consultar con graphify query primero, la misma pregunta se resolvió en una sola llamada y con 30 mil tokens.
En otro issue, un usuario con un proyecto de unas 1,484 archivos comentaba que cada consulta rondaba los 2 mil tokens, y que encadenar tres o cuatro sumaba más de 8 mil, comparable con lo que gastaba Claude Code usando búsquedas tradicionales.
La moraleja: mide en tu propio proyecto. Y fíjate en algo que cierra el círculo con el artículo pasado: hasta una herramienta pensada para ahorrar tokens necesitó que personas reales notaran el problema, lo reportaran y lo corrigieran. Detrás de cada prompt hay un ser humano, y detrás de cada herramienta también.
Cómo empezar
Necesitas Python 3.10 o superior y, de preferencia, uv. Luego:
# <span id="sec-7-instala-el-cli-ojo-el-paquete-oficial-lleva-doble-y" class="scroll-mt-28"></span>Instala el CLI (ojo: el paquete oficial lleva doble "y")
uv tool install graphifyy

# <span id="sec-8-registra-la-skill-en-tu-asistente-de-ia" class="scroll-mt-28"></span>Registra la skill en tu asistente de IA
graphify install
Después, en tu asistente, dentro de tu proyecto:
/graphify .
Un par de notas para no tropezar: el paquete oficial en PyPI es graphifyy (con doble "y"), y otros paquetes que empiezan con graphify no están afiliados al proyecto. En PowerShell usa graphify . sin la barra inicial, y en Codex el comando es $graphify.
Algunos pasos que ayudan a sacarle más provecho:
- Crea un
.graphifyignorepara excluir carpetas que no aportan (dependencias, builds, archivos generados). - Corre
graphify claude install(o el comando de tu plataforma) para que tu asistente consulte el grafo por defecto. - Instala los hooks con
graphify hook installpara que el grafo se actualice con cada commit, y corregraphify update .después de cadagit pull. - Si usas Claude Code, agrega
graph.jsonygraphify-out/a tu.claudeignore, porque según la documentación, esos archivos pueden invalidar la caché de prompts cada vez que cambian.
¿Cuándo sí y cuándo no?
Tiene mucho sentido si trabajas con proyectos grandes con muchos módulos, si heredas código que no escribiste, si tu repo mezcla código con documentación, PDFs o diagramas, o si en tu equipo quieren compartir un mismo grafo (se puede versionar graph.json para eso).
Tiene menos sentido en scripts o proyectos de pocos archivos. Ahí la IA ya puede leerlo todo sin problema y lo único que ganas es claridad.
El grafo te dice qué hay, tú decides por qué
Graphify no reemplaza al ARCHITECTURE.md que escribes a mano. El grafo te muestra qué existe y cómo se conecta; tu documentación explica por qué se decidió así. Una herramienta que dibuja mapas no sabe hacia dónde quieres ir, y eso sigue siendo cosa tuya. Por eso, todo lo que hablamos en esta serie, desde la arquitectura hasta los .md, se complementa: una buena base, un buen contexto y una buena herramienta para que la IA trabaje a tu favor y no al revés.
En el próximo artículo vamos a hablar de algo que lo cambia todo y casi nadie cuida: cómo hablarle bien a una IA, y por qué el mismo modelo puede darte una respuesta brillante o una mediocre dependiendo de cómo se lo pidas.
Ten un feliz fin de semana, y recuerda que el avance no es algo a lo que debamos temerle, sino algo con lo que debemos aprender a trabajar.